Claude Codeのモデル使い分け|3層に分けた基準と、安いモデルで壊れた実例【2026年版】

目次
Claude Codeを業務で使い始めると、早い段階で同じ問いにぶつかります。「全部いちばん賢いモデルでやればいいのか、それとも安いモデルに振り分けるべきか」。請求額を見た経理からは下げてくれと言われ、現場からは品質を落とすなと言われる。間に立った担当者が、作業のたびにモデルを選び直すことになります。
当社は営業・マーケの定型業務をClaude Codeの定時実行で回していて、1日あたりおよそ21本のタスクが自動で走っています。そのモデルの割り当てを何度も間違え、直してきました。この記事は、その過程で落ち着いた「3層に分ける」基準と、安いモデルに落として壊れたもの・高いモデルのまま回して高くついたものの記録です。
先に結論を書くと、モデルは仕事の難しさではなく、失敗したときに誰が困るかで選ぶと迷わなくなります。
この記事の要点
- モデル選びの軸は「難しさ」ではなく「失敗したとき誰が困るか」。社内で取り返せる作業・社外に出る文章・型のない判断の3層に分ける
- 当社の記録時点の単価(100万トークンあたり入力/出力)はSonnet $2/$10、Opus 5.5 $4/$20、Fable 5.1 $10/$50。最上位と機械作業用で5倍違う
- 安いほうに落としすぎた例:Haikuで長い日本語を入力させたところ、簡体字(专・饮など)や字の取り違えが混ざった。以後、日本語を正確に再現する工程はSonnet以上に固定した
- 高いほうで回しすぎた例:記事1本を公開する定時タスクが1回$32・86ターン。ターンの大半は画像生成と公開後の確認で、文章の質とは無関係だった
- 「この工程は安いモデルに任せる」と手順書に書いても、守られなかった。8月22日の実行では委譲が0回で、親のモデルが81回の処理をすべて自分で行っていた
結論|「失敗したときに誰が困るか」で3層に分ける
モデルを選ぶとき、多くの人は「この作業は難しいか」を考えます。ところが、難しさは作業の途中で変わりますし、人によって見立てもぶれます。当社が最終的に使っている問いは、この作業が失敗したら、誰がどれだけ困るかです。
| 層 | 失敗したときに困る人 | 当社の割り当て | 代表的な作業 |
|---|---|---|---|
| ① 機械作業 | 社内の自分だけ(その日のうちに取り返せる) | Sonnet | 数字の収集・ファイルの整理・公開後の表示確認・決まった形式への流し込み |
| ② 社外に出る文章 | 顧客・読者(出た瞬間に信用が減る) | Opus 5.5 | 記事・提案書の本文・顧客宛てのメール文面 |
| ③ 型のない判断 | 事業そのもの(間違えると数週間ずれる) | Fable 5.1 | 週1回の振り返りと打ち手の決定・一社ごとに書き分ける営業文面 |
①は、失敗しても気づいた時点でやり直せば済みます。②は、一度顧客に届いた文章は取り消せません。③は、間違えたこと自体に数週間気づけないことがあります。取り消しにくいものほど上のモデルに置く、というだけの基準です。
この割り当てを全部の定時タスクに当てはめ直したところ、Sonnetに置けるタスクが16本ありました。最上位のFableに残したのは、週1回の振り返りと、一社ごとに文面を書き分ける営業の2つだけです。
3つの層の単価差は、最大5倍ある
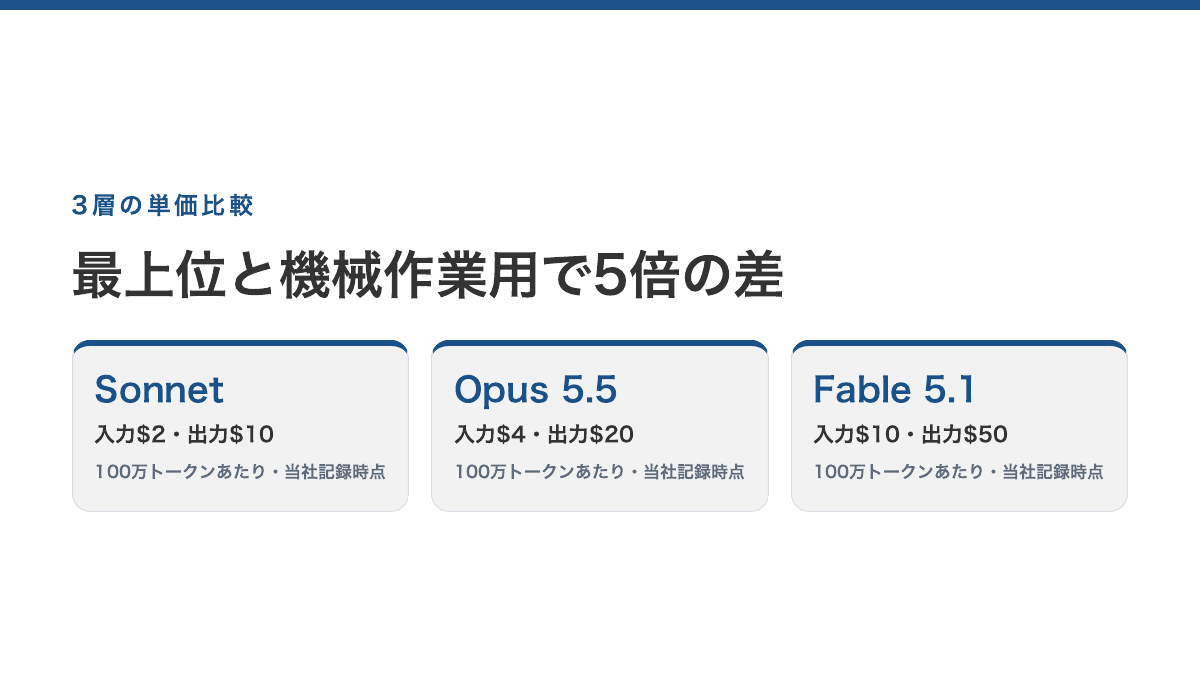
当社が切り替えのたびに記録してきた単価は次のとおりです(100万トークンあたり。料金は改定されるので、導入時は必ず公式の料金表で確認してください)。
| モデル | 入力 | 出力 | 当社での位置づけ |
|---|---|---|---|
| Sonnet | $2 | $10 | 機械作業。ブラウザ操作やスクリプト実行のように、入力と出力の量が多い工程 |
| Opus 5.5 | $4 | $20 | 社外に出る文章。2026年9月に旧Opusから切り替えた(公称では旧版よりコスト4割減) |
| Fable 5.1 | $10 | $50 | 型のない判断。週1回の振り返りで、1回あたり$20〜34 |
ブラウザを操作する、ファイルを読み書きする、といった機械作業は、新しく読み込む量も書き出す量も多くなりがちです。この種の工程をFableで回すと、Sonnetの5倍の単価がそのまま掛かります。逆に、文章の質がそのまま信用になる工程をSonnetに落としても、浮く金額はOpusとの差(入出力とも2倍)にとどまります。
つまり、節約の効き目が大きいのは「文章を安いモデルで書かせる」ことではなく、機械作業を上位モデルから降ろすことです。
安いモデルに落として壊れたもの|長い日本語の再現
単価だけを見るなら、さらに安いHaikuを使う選択肢もあります。当社も、問い合わせフォームに日本語の本文を流し込む作業で、費用を下げるためにHaikuを使った時期がありました。
結果は、入力した本文に簡体字が混ざる(「专」「饮」など)、似た形の別の字に置き換わるといった壊れ方でした。入力後に読み戻して確認する手順を足しても、取り切れませんでした。
| 起きたこと | 原因の見立て | 取った対策 |
|---|---|---|
| 日本語の本文に簡体字が混ざった | 長い日本語を一字ずつ正確に再現する工程で、モデル側が崩れた | 日本語を正確に入れる工程はSonnet以上に固定 |
| 似た形の別の字への置き換わり(住所など) | 同上。フォーム側の文字コードの問題ではなかった | 入力後に読み戻し、簡体字・誤字を検査してから先へ進む |
| 確認手順を足しても取り切れなかった | 確認する側も同じモデルだった | 「安いモデルで作って、安いモデルで確認する」をやめた |
問い合わせフォームに簡体字の混ざった文章が届けば、それを読んだ担当者の印象は戻りません。①の機械作業に見えて、実際は社外に出る文章(②)だったわけです。モデルを選ぶ前に、その作業が最終的に誰の目に触れるかまでたどる必要があります。
Haikuが悪いという話ではありません。英数字が中心の処理、短い分類、リンク集めのような純粋な機械操作なら十分に使えます。長い日本語を一字も崩さずに出す工程にだけは置かない、というのが当社の線引きです。
高いモデルのまま回して高くついたもの|1回$32・86ターン
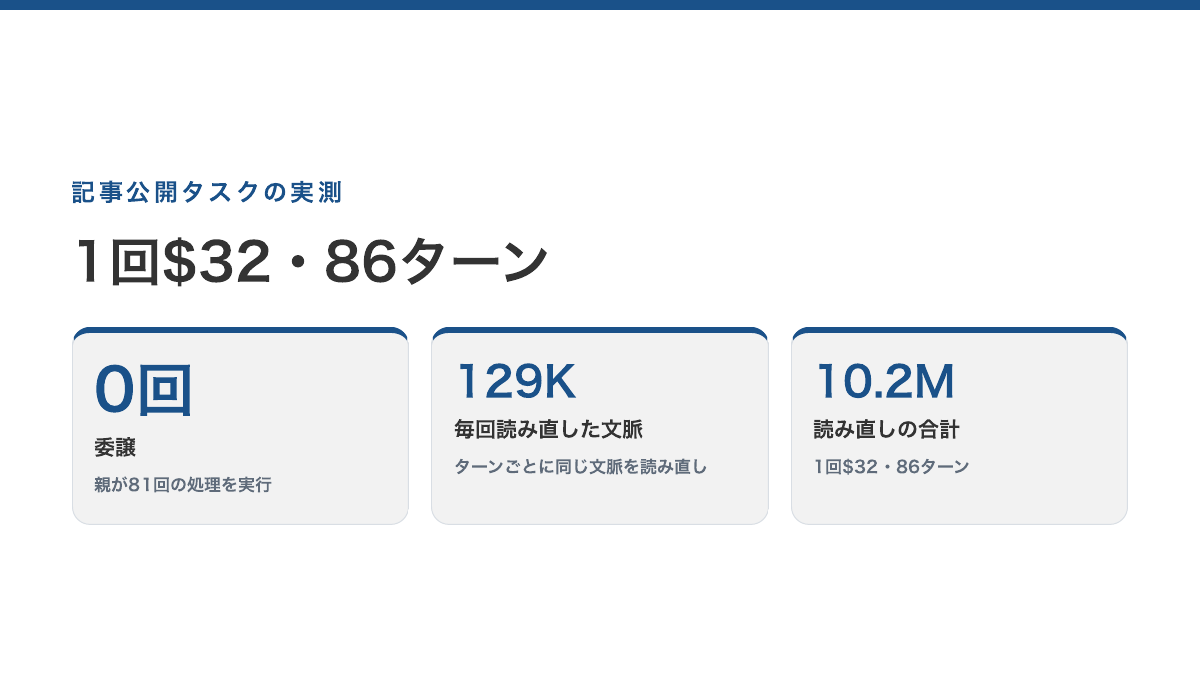
反対側の失敗もあります。自社メディアに記事を1本公開する定時タスクを、当初はすべて上位モデルで回していました。実測すると1回$32・86ターン。中身を分解すると、ターンの大半は画像の生成、公開作業、公開後の表示確認でした。文章の質とは関係のない工程に、文章用のモデルの単価を払っていたことになります。
そこで、本文を書くところまでは上位モデル、そこから先の画像・公開・確認はSonnetの子エージェントに渡す、と分けました。ここで大事なのは、単価の差だけではありません。
上位モデルが最後まで作業を続けると、公開や確認のような短い作業のたびに、書き上げた記事の全文を含む長い文脈を読み直すことになります。8月22日の実行では、1回の処理で読み直す文脈が129Kあり、それを81回繰り返して、読み直しの合計は10.2Mに達していました。子エージェントに渡せば、子は必要なファイルだけを読んで始められます。
同じ会話を長く続けると1ターンの単価が膨らむ現象は、Claude Code法人利用の料金と「本当のコスト」で、当社のログから3.9倍になった記録として詳しく書いています。モデルの使い分けは、この「読み直しの量」を減らす手段でもあります。
分けると決めても、分かれなかった|委譲で起きた2つの事故
ここまで読むと、「手順書に『この工程は安いモデルに任せる』と書けば済む」と思われるかもしれません。当社もそう考えていました。実際には、書いただけでは守られませんでした。
1つ目:委譲が1回も起きていなかった。 8月17日に「画像生成以降はSonnetに渡す」と手順書に書き足しました。ところが8月22日の実行を記録から確認すると、子エージェントの呼び出しは0回。親の上位モデルが、81回の処理をすべて自分で行っていました。エラーは出ていないので、記録を見に行かなければ気づけない種類の失敗です。対策として、「執筆が終わった直後の最初の1手は、必ず委譲の呼び出しにする」と、順番で固定しました。
2つ目:委譲したら、結果を待たずに終わってしまった。 9月30日、月に1回だけ走る観測タスクで、親が子エージェントを裏で起動し、「30分後に確認します」と書いて自分のターンを終えました。定時実行は1ターンで終わる仕組みなので、親が終わった時点で子も途中で打ち切られ、その月の観測データは取れませんでした。翌日の月次会議は、前月の数字で代用しています。対策は「子を起動したら、戻ってくるまで親は終わらない」「待てない形なら親が自分でやる」の2点を手順に明記することでした。
| 事故 | 何が起きたか | 気づけた理由 | 直し方 |
|---|---|---|---|
| 委譲0回 | 「任せる」と書いたのに、親が81回すべて実行 | 記録の呼び出し回数を数えた | 委譲を「執筆直後の最初の1手」に固定 |
| 待たずに終了 | 子を裏で起動し、親が先に終わって子も打ち切り | その日の観測データが無かった | 子の完了まで親を終わらせない・待てないなら親が実行 |
どちらも、モデルの能力の問題ではなく、分担の段取りの問題でした。使い分けを決めた日より、それが実際に守られているかを確かめた日のほうが大事です。落ちたことに気づく仕組みの作り方はClaude Codeのスケジュール実行にまとめています。
反論:「最上位モデル1本にまとめたほうが、管理は楽では?」
この反論はもっともです。モデルを分ければ、割り当て表を持つ手間が増え、上の2つの事故のような「分担の失敗」も起こり得ます。1本にまとめれば、少なくとも品質の下限は揃います。
それでも当社が分けているのは、まとめた場合の負け方のほうが見えにくいからです。最上位モデル1本の請求は、使う人とタスクが増えるたびに5倍の単価で伸びます。しかも、子エージェントの消費は親の記録に出ません。当社の実測では、親と子の消費量の比が約1:11でした。親の画面だけを見て「思ったより安い」と判断していると、実際の請求とは桁が違ってきます。
一方で、1本にまとめてよい段階もあります。使う人が1〜2人で、定時実行がまだ無く、月の請求が気にならない間は、分ける手間のほうが高くつきます。分け始めるのは、定時実行が週に数本を超えたとき、または同じ作業を3人以上が毎日行うようになったときで十分です。
チームに広げる前に決める3つのこと
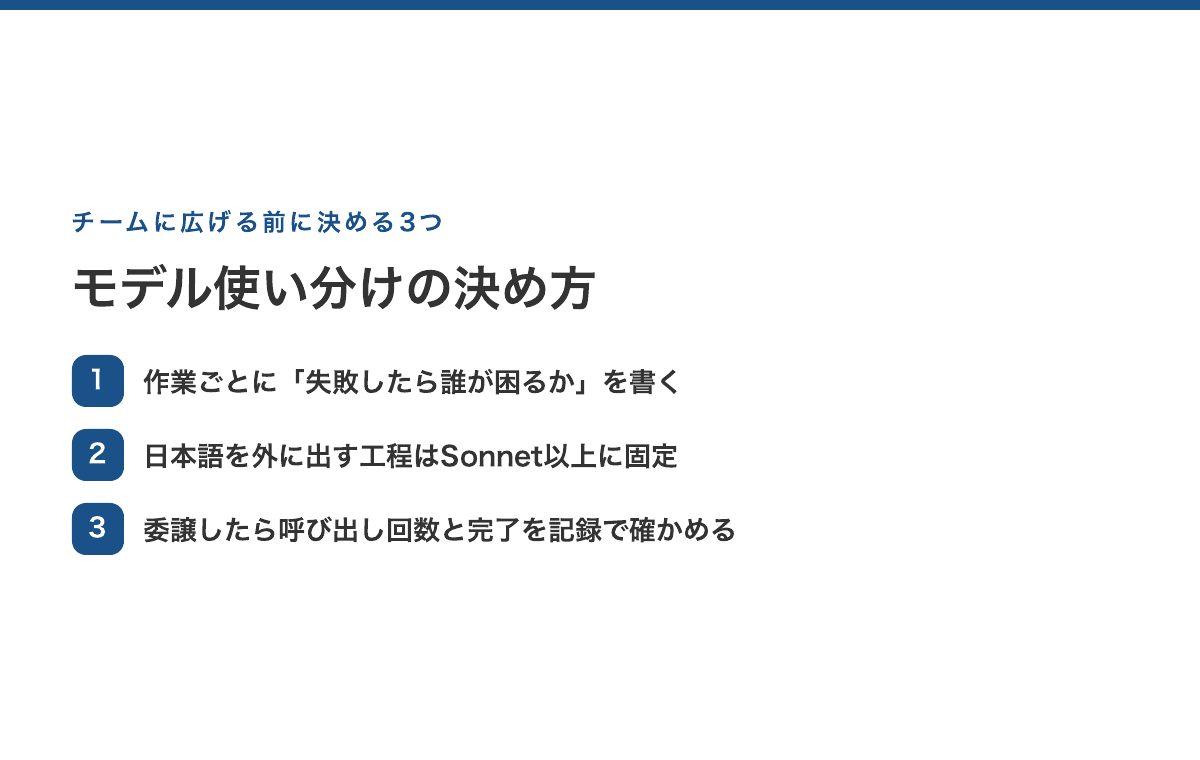
営業やマーケのチームでClaude Codeを使う人が増えるとき、モデルの割り当てを個人の判断に任せると、同じ作業でも人によって5倍の単価差が出ます。広げる前に、次の3つだけは決めておくことをおすすめします。
- 作業ごとに「失敗したら誰が困るか」を1行で書く。 顧客の目に触れるか、社内で取り返せるかの2択で十分です。迷ったら顧客側に倒します
- 日本語を外に出す工程は、Sonnet以上に固定する。 提案書、メール、フォームへの入力、議事録の社外共有版。ここで節約しても、浮くのは数ドルで、失うのは商談です
- 委譲したら、呼び出し回数と完了を記録で確かめる。 決めたことが守られているかを週に1回だけ見る。当社が2回とも事故に気づけたのは、記録を数えに行ったからでした
営業の現場で言えば、モデルの使い分けは「誰にどの仕事を任せるか」という配置の話です。新人に任せてよい事務作業と、ベテランに任せる顧客対応と、責任者が決める方針を分けるのと同じで、全員を責任者の単価で働かせる組織はありません。導入をどこから始めるかの見立てはClaude Code導入支援の費用相場と失敗しない選び方にまとめています。
よくある質問
Q. Claude CodeでOpusとSonnetはどう使い分ければいいですか?
顧客や読者の目に触れる文章はOpus、それ以外の機械作業はSonnetが出発点です。当社の記録時点の単価はSonnetが入力$2・出力$10、Opus 5.5が$4・$20で、ちょうど2倍の差です。迷った作業は「失敗したら誰が困るか」で判定し、社外の人が困るならOpus側に置きます。
Q. いちばん安いHaikuは業務に使えませんか?
使えます。英数字中心の処理、短い分類、リンク集めのような純粋な機械操作なら十分です。ただし当社では、長い日本語の本文を正確に入力させたときに簡体字や字の取り違えが混ざったため、日本語を外に出す工程には使っていません。
Q. 最上位モデルはどんな作業に使うべきですか?
手順に落とせない判断だけです。当社では、週1回の振り返りで次の打ち手を決める作業と、一社ごとに書き分ける営業文面の2つにしか使っていません。振り返りは1回$20〜34かかりますが、ここを外すと数週間単位で方向がずれるため、削る対象にはしていません。
Q. 子エージェント(サブエージェント)に別のモデルを割り当てると、本当に安くなりますか?
単価の差に加えて、読み直す文脈が短くなる効果があります。当社の記事公開タスクでは、親が最後まで作業した回は毎回129Kの文脈を読み直し、合計10.2Mになっていました。ただし、子の消費は親の記録に出ないので、親と子を合算して比べる必要があります。
Q. モデルを使い分けると、品質管理が大変になりませんか?
なります。だから、品質の基準をモデルではなく手順書とチェックに持たせます。どのモデルが実行しても同じ確認項目を通るようにしておけば、モデルを切り替えたときに品質が落ちたかどうかもすぐに分かります。手順書に書くだけでは守られない点はClaude Codeは危険かで詳しく書いています。
---
執筆・監修:佐々木 優希(AIリモートワーカー代表/上場企業 営業統括 兼 AI責任者)
自社の営業・マーケ業務をClaude Codeの定時実行で運用しており、本記事の単価・実測値・事故の記録はすべて自社の運用記録に基づいています。